Todo protocolo DeFi tem um segredo a vozes: o smart contract é a menor parte do sistema.
O código Solidity ou Rust que vive on-chain gerencia os invariantes — o que é permitido, o que não é, quais mudanças de estado são válidas. Mas um protocolo de empréstimo que não liquida posições subcapitalizadas a tempo, um AMM que não consegue atualizar seus price feeds sob congestionamento, ou uma bridge que silenciosamente perde eventos durante um reorg — nenhum desses falha no nível do smart contract. Eles falham na infraestrutura off-chain que a maioria dos times constrói como uma reflexão tardia.
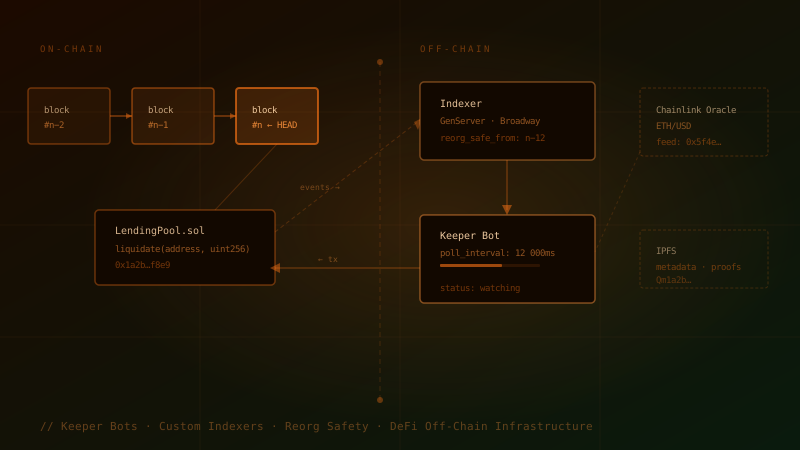
Este artigo é sobre essa infraestrutura: keeper bots, indexadores on-chain, pipelines de event listeners, e os padrões operacionais que separam os protocolos que sobrevivem sob estresse dos que não sobrevivem.
O que “Off-Chain” Significa na Prática
A EVM (e Solana, e qualquer outra plataforma de smart contracts) é uma máquina de estados. Ela transiciona estados de forma determinística em resposta a transações. Mas uma máquina de estados não pode iniciar nada — ela só responde a inputs. Alguém ou algo precisa submeter essas transações.
A infraestrutura off-chain é o conjunto de serviços que:
- Observam o estado da chain em busca de condições que requerem ação
- Calculam qual ação tomar (e quando)
- Submetem transações que disparam a lógica on-chain
- Indexam eventos on-chain para que sua aplicação possa consultar o histórico sem re-escanear a chain
Para um protocolo de empréstimo típico, isso significa:
- Um keeper de liquidação que monitora health factors e submete transações de liquidação quando posições ficam subcapitalizadas
- Um relayer de price feeds que empurra atualizações de oracle on-chain antes que fiquem desatualizadas
- Um indexador de eventos que rastreia depósitos, empréstimos, pagamentos e liquidações para o frontend e analytics
- Uma camada de monitoramento que alerta sobre reorgs, eventos perdidos e falhas do keeper
Deixe qualquer um desses falhar e o protocolo quebra — não lentamente, mas de maneiras que custam dinheiro real aos usuários.
Construindo um Keeper de Liquidação com Elixir
Um keeper de liquidação é um ótimo exemplo porque os requisitos parecem simples mas as restrições de produção são brutais. Você precisa:
- Sondar ou assinar o estado da chain continuamente
- Calcular health factors para milhares de posições
- Submeter transações de liquidação com preços de gas competitivos durante picos
- Lidar com reorgs sem envio duplo ou posições perdidas
- Recuperar de falhas de RPC sem perder posições
Este é um problema OTP clássico. Cada posição sob monitoramento pode ser um processo supervisionado. A detecção de reorgs é um GenServer rastreando o último bloco finalizado. O pipeline de submissão é um consumidor Broadway com backpressure.
defmodule Keeper.PositionMonitor do
  use GenServer

  @check_interval 12_000  # um bloco ETH

  def start_link(position_id) do
    GenServer.start_link(__MODULE__, position_id,
      name: {:via, Registry, {Keeper.Registry, {:position, position_id}}}
    )
  end

  def init(position_id) do
    schedule_check()
    {:ok, %{position_id: position_id, last_health: nil}}
  end

  def handle_info(:check, %{position_id: id} = state) do
    with {:ok, health_factor} <- Keeper.Chain.get_health_factor(id),
         true <- health_factor < Decimal.new("1.0") do
      Keeper.LiquidationQueue.enqueue(id, health_factor)
    end

    schedule_check()
    {:noreply, %{state | last_health: health_factor}}
  end

  defp schedule_check, do: Process.send_after(self(), :check, @check_interval)
end
Cada posição roda como um processo supervisionado independente. Se um falhar — resposta RPC ruim, nil inesperado no cálculo do health factor — o supervisor o reinicia. O restante das posições continua sem ser afetado.
A fila de liquidação alimenta um pipeline Broadway que gerencia a submissão real de transações:
defmodule Keeper.LiquidationPipeline do
  use Broadway

  def start_link(_opts) do
    Broadway.start_link(__MODULE__,
      name: __MODULE__,
      producer: [
        module: {Broadway.DummyProducer, []},
        concurrency: 1
      ],
      processors: [
        default: [concurrency: 5]  # 5 tentativas de liquidação em paralelo
      ]
    )
  end

  def handle_message(_, %{data: {position_id, health_factor}} = msg, _) do
    case Keeper.Executor.liquidate(position_id) do
      {:ok, tx_hash} ->
        Logger.info("Liquidado #{position_id}: #{tx_hash}")
        msg

      {:error, :already_liquidated} ->
        # Perdemos a corrida — outro keeper chegou primeiro
        Broadway.Message.failed(msg, :race_condition)

      {:error, reason} ->
        Broadway.Message.failed(msg, reason)
    end
  end
end
O concurrency: 5 nos processors significa que podemos tentar cinco liquidações simultaneamente — importante quando uma queda do mercado cria centenas de posições liquidáveis de uma vez. O modelo de backpressure do Broadway também evita que sobrecarreguemos nosso provedor RPC com requisições.
Tratamento de Reorgs: A Parte que Todo Mundo Ignora
Um reorg do Ethereum acontece quando a rede reorganiza sua ponta de chain — blocos que você achava que estavam confirmados são substituídos. Para um keeper, isso significa:
- Uma liquidação que você submeteu no bloco N pode estar em um bloco que é reorgado
- Posições que você achava liquidadas podem ser “des-liquidadas” na nova ponta de chain
- Eventos que você indexou de blocos revertidos precisam ser removidos
A maioria das implementações de keepers que auditei trata o caminho feliz e ignora reorgs completamente. Isso está bem até que um reorg aconteça durante alta volatilidade — exatamente quando seu keeper é mais crítico.
defmodule Keeper.ChainMonitor do
  use GenServer

  @reorg_depth 12  # considerar blocos finais após 12 confirmações

  def init(_) do
    {:ok, %{finalized_block: 0, pending: %{}}}
  end

  def handle_info({:new_block, block}, state) do
    # Verificar se algum bloco pendente foi reorgado
    {valid, reorged} = state.pending
      |> Map.split_with(fn {_hash, number} ->
        number <= block.number - @reorg_depth or
        Keeper.Chain.block_exists?(hash)
      end)

    # Reprocessar posições afetadas por blocos reorgados
    Enum.each(reorged, fn {_hash, _number} ->
      Keeper.PositionReconciler.reconcile_affected_positions()
    end)

    new_pending = valid |> Map.put(block.hash, block.number)
    {:noreply, %{state | pending: new_pending, finalized_block: block.number - @reorg_depth}}
  end
end
A chave: não tratar nada como final até que tenha pelo menos 12 blocos de profundidade. Manter um mapa de blocos pendentes. Quando você ver um bloco a profundidade 12 que não existe mais na chain, você teve um reorg — reconcilie.
Indexação: Por Que Não Usar Só o The Graph?
The Graph é excelente para padrões padrão de ERC-20 e ERC-721. Para lógica de protocolo complexa — roteamento multi-hop, agregação de estado cross-contract, consultas condicionais — você frequentemente precisa de um indexador personalizado.
A arquitetura é mais simples do que parece:
defmodule Indexer.EventListener do
  use GenServer

  def init(config) do
    {:ok, filter_id} = Indexer.RPC.subscribe_logs(%{
      address: config.contract_address,
      topics: config.event_topics
    })

    {:ok, %{filter_id: filter_id, last_block: config.from_block}}
  end

  def handle_info(:poll, state) do
    {:ok, logs} = Indexer.RPC.get_filter_changes(state.filter_id)

    logs
    |> Enum.map(&Indexer.Decoder.decode_log/1)
    |> Enum.each(&Indexer.Store.upsert_event/1)

    schedule_poll()
    {:noreply, %{state | last_block: max_block(logs, state.last_block)}}
  end
end
Armazene eventos decodificados no Postgres. Indexe por número de bloco, hash de transação e os campos de domínio que você consulta. Um protocolo de empréstimo tipicamente precisa de consultas como “todos os eventos de borrow para a conta X” e “depósitos totais por ativo nos últimos 7 dias” — nenhuma delas é barata de calcular re-escaneando o histórico da chain toda vez.
O detalhe importante: sempre armazene o número de bloco e o log index junto a cada evento. Isso é o que te permite lidar com reorgs — quando o bloco 14.502 é reorgado, você deleta todos os eventos onde block_number = 14502 e re-indexa a partir desse bloco.
O que Realmente Quebra em Produção
Depois de rodar keepers e indexadores em mainnet em múltiplos protocolos, aqui está o que causa incidentes reais:
Falhas do provedor RPC. Setups de provedor único falham. Use pelo menos dois — Alchemy e Infura, ou um gerenciado e um nó próprio. Troque em caso de falha. O padrão de circuit breaker do Elixir se aplica diretamente aqui.
Picos de preço de gas durante cascatas de liquidação. Quando múltiplas posições ficam liquidáveis simultaneamente (uma queda repentina), o preço do gas pode subir 10–50x em segundos. Seu keeper precisa de preços de gas dinâmicos — seja ajuste de tip EIP-1559 ou um gas oracle. Um keeper que submete com baseFee + 1 gwei durante um pico nunca será incluído.
Acumulação de memória em indexadores de longa execução. Indexadores que processam milhões de eventos acumulam estado ao longo do tempo. Faça profiling do tamanho do heap depois de 72 horas de operação contínua, não apenas durante o desenvolvimento. Processos GenServer em Elixir têm seu próprio GC, o que ajuda — mas a fila de escrita no Postgres ainda pode se acumular se seu indexador processar mais rápido do que consegue escrever.
Eventos perdidos durante reconexões de websocket RPC. Conexões websocket caem. Durante a janela de reconexão, você perde eventos. A solução: sempre mantenha um cursor last_indexed_block e faça backfill dos eventos perdidos ao reconectar usando o método RPC eth_getLogs com um intervalo de blocos.
Checklist para Produção
Antes de ir ao ar:
- Dois provedores RPC independentes com failover automático
- Detecção de reorgs com profundidade de finalidade configurável (12 para mainnet, 3 para rollups otimistas)
- Estratégia de competição do keeper — você está protegido contra MEV, ou aceita a corrida?
- Integração com gas oracle com limites mínimos e máximos
- Backfill de eventos ao reiniciar o indexador
- Alerta sobre heartbeats perdidos de processos keeper
- Deployment separado para indexador (leitura) e keeper (escrita) — eles têm modos de falha e características de escalabilidade diferentes
O protocolo on-chain é a parte fácil. A infraestrutura off-chain é onde os protocolos realmente vivem ou morrem.
Marcado em