Todo protocolo DeFi tiene un secreto a voces: el smart contract es la parte más pequeña del sistema.
El código Solidity o Rust que vive on-chain gestiona los invariantes — qué está permitido, qué no, qué cambios de estado son válidos. Pero un protocolo de préstamos que no liquida posiciones subcapitalizadas a tiempo, un AMM que no puede actualizar sus price feeds bajo congestión, o un bridge que silenciosamente pierde eventos durante un reorg — ninguno de estos falla a nivel de smart contract. Fallan en la infraestructura off-chain que la mayoría de equipos construye como una ocurrencia tardía.
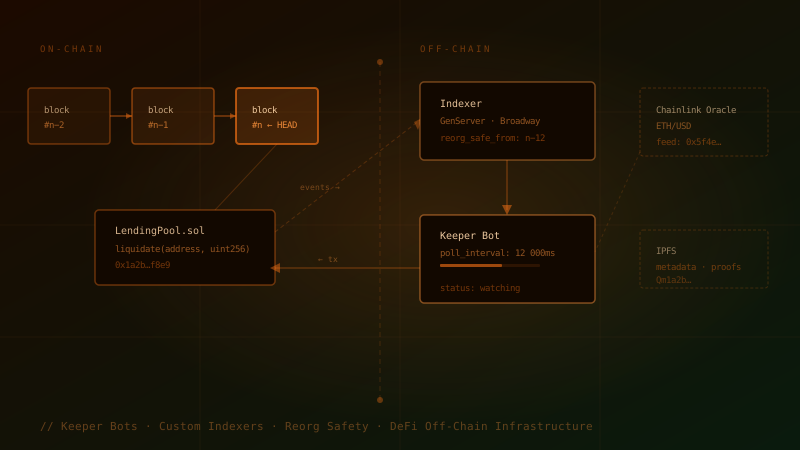
Este artículo trata sobre esa infraestructura: keeper bots, indexadores on-chain, pipelines de event listeners, y los patrones operacionales que separan los protocolos que sobreviven bajo estrés de los que no.
Qué Significa “Off-Chain” en la Práctica
La EVM (y Solana, y cualquier otra plataforma de smart contracts) es una máquina de estados. Transiciona estados de forma determinista en respuesta a transacciones. Pero una máquina de estados no puede iniciar nada — solo responde a inputs. Alguien o algo tiene que enviar esas transacciones.
La infraestructura off-chain es el conjunto de servicios que:
- Observan el estado de la cadena en busca de condiciones que requieran acción
- Calculan qué acción tomar (y cuándo)
- Envían transacciones que disparan la lógica on-chain
- Indexan eventos on-chain para que tu aplicación pueda consultar el historial sin re-escanear la cadena
Para un protocolo de préstamos típico, esto implica:
- Un keeper de liquidación que monitorea health factors y envía transacciones de liquidación cuando las posiciones se subcapitalizan
- Un relayer de price feeds que empuja actualizaciones de oracle on-chain antes de que caduquen
- Un indexador de eventos que rastrea depósitos, préstamos, repagos y liquidaciones para el frontend y analytics
- Una capa de monitoreo que alerta sobre reorgs, eventos perdidos y fallos del keeper
Falla cualquiera de estos y el protocolo se rompe — no lentamente, sino de maneras que cuestan dinero real a los usuarios.
Construyendo un Keeper de Liquidación con Elixir
Un keeper de liquidación es un gran ejemplo porque los requisitos parecen simples pero las restricciones de producción son brutales. Necesitas:
- Sondear o suscribirte al estado de la cadena de forma continua
- Calcular health factors para miles de posiciones
- Enviar transacciones de liquidación con precios de gas competitivos durante picos
- Manejar reorgs sin doble envío ni posiciones perdidas
- Recuperarte de fallos de RPC sin perder posiciones
Este es un problema OTP de manual. Cada posición bajo monitoreo puede ser un proceso supervisado. La detección de reorgs es un GenServer que rastrea el último bloque finalizado. El pipeline de envío es un consumidor Broadway con backpressure.
defmodule Keeper.PositionMonitor do
  use GenServer

  @check_interval 12_000  # un bloque ETH

  def start_link(position_id) do
    GenServer.start_link(__MODULE__, position_id,
      name: {:via, Registry, {Keeper.Registry, {:position, position_id}}}
    )
  end

  def init(position_id) do
    schedule_check()
    {:ok, %{position_id: position_id, last_health: nil}}
  end

  def handle_info(:check, %{position_id: id} = state) do
    with {:ok, health_factor} <- Keeper.Chain.get_health_factor(id),
         true <- health_factor < Decimal.new("1.0") do
      Keeper.LiquidationQueue.enqueue(id, health_factor)
    end

    schedule_check()
    {:noreply, %{state | last_health: health_factor}}
  end

  defp schedule_check, do: Process.send_after(self(), :check, @check_interval)
end
Cada posición corre como un proceso supervisado independiente. Si uno falla — mala respuesta de RPC, nil inesperado en el cálculo del health factor — el supervisor lo reinicia. El resto de posiciones continúa sin verse afectado.
La cola de liquidación alimenta un pipeline Broadway que maneja el envío real de transacciones:
defmodule Keeper.LiquidationPipeline do
  use Broadway

  def start_link(_opts) do
    Broadway.start_link(__MODULE__,
      name: __MODULE__,
      producer: [
        module: {Broadway.DummyProducer, []},
        concurrency: 1
      ],
      processors: [
        default: [concurrency: 5]  # 5 intentos de liquidación en paralelo
      ]
    )
  end

  def handle_message(_, %{data: {position_id, health_factor}} = msg, _) do
    case Keeper.Executor.liquidate(position_id) do
      {:ok, tx_hash} ->
        Logger.info("Liquidado #{position_id}: #{tx_hash}")
        msg

      {:error, :already_liquidated} ->
        # Perdimos la carrera — otro keeper llegó primero
        Broadway.Message.failed(msg, :race_condition)

      {:error, reason} ->
        Broadway.Message.failed(msg, reason)
    end
  end
end
El concurrency: 5 en processors significa que podemos intentar cinco liquidaciones simultáneamente — importante cuando una caída del mercado crea cientos de posiciones liquidables a la vez. El modelo de backpressure de Broadway también evita que saturemos a nuestro proveedor RPC con solicitudes.
Manejo de Reorgs: La Parte que Todos se Saltan
Un reorg de Ethereum ocurre cuando la red reorganiza su punta de cadena — bloques que creías confirmados se reemplazan. Para un keeper, esto significa:
- Una liquidación que enviaste en el bloque N puede estar en un bloque que se reorganiza
- Posiciones que creías liquidadas pueden “des-liquidarse” en la nueva punta de cadena
- Eventos que indexaste de bloques revertidos deben eliminarse
La mayoría de implementaciones de keepers que he auditado manejan el camino feliz e ignoran los reorgs por completo. Esto está bien hasta que ocurre un reorg durante alta volatilidad — exactamente cuando tu keeper es más crítico.
defmodule Keeper.ChainMonitor do
  use GenServer

  @reorg_depth 12  # considerar bloques finales después de 12 confirmaciones

  def init(_) do
    {:ok, %{finalized_block: 0, pending: %{}}}
  end

  def handle_info({:new_block, block}, state) do
    # Verificar si algún bloque pendiente fue reorgado
    {valid, reorged} = state.pending
      |> Map.split_with(fn {_hash, number} ->
        number <= block.number - @reorg_depth or
        Keeper.Chain.block_exists?(hash)
      end)

    # Reprocesar posiciones afectadas por bloques reorgados
    Enum.each(reorged, fn {_hash, _number} ->
      Keeper.PositionReconciler.reconcile_affected_positions()
    end)

    new_pending = valid |> Map.put(block.hash, block.number)
    {:noreply, %{state | pending: new_pending, finalized_block: block.number - @reorg_depth}}
  end
end
La clave: no tratar nada como final hasta que tenga al menos 12 bloques de profundidad. Mantener un mapa de bloques pendientes. Cuando veas un bloque a profundidad 12 que ya no existe en la cadena, tuviste un reorg — reconcilia.
Indexación: ¿Por Qué No Usar Solo The Graph?
The Graph es excelente para patrones estándar de ERC-20 y ERC-721. Para lógica de protocolo compleja — enrutamiento multi-hop, agregación de estado cross-contract, consultas condicionales — a menudo necesitas un indexador personalizado.
La arquitectura es más simple de lo que parece:
defmodule Indexer.EventListener do
  use GenServer

  def init(config) do
    {:ok, filter_id} = Indexer.RPC.subscribe_logs(%{
      address: config.contract_address,
      topics: config.event_topics
    })

    {:ok, %{filter_id: filter_id, last_block: config.from_block}}
  end

  def handle_info(:poll, state) do
    {:ok, logs} = Indexer.RPC.get_filter_changes(state.filter_id)

    logs
    |> Enum.map(&Indexer.Decoder.decode_log/1)
    |> Enum.each(&Indexer.Store.upsert_event/1)

    schedule_poll()
    {:noreply, %{state | last_block: max_block(logs, state.last_block)}}
  end
end
Almacena los eventos decodificados en Postgres. Indexa por número de bloque, hash de transacción y los campos de dominio que consultes. Un protocolo de préstamos típicamente necesita consultas como “todos los eventos de borrow para la cuenta X” y “depósitos totales por activo en los últimos 7 días” — ninguna es barata de calcular re-escaneando el historial de la cadena cada vez.
El detalle importante: siempre almacena el número de bloque y el log index junto a cada evento. Esto es lo que te permite manejar reorgs — cuando el bloque 14.502 es reorgado, eliminas todos los eventos donde block_number = 14502 y re-indexas desde ese bloque.
Qué Falla Realmente en Producción
Después de correr keepers e indexadores en mainnet en múltiples protocolos, esto es lo que causa incidentes reales:
Fallos del proveedor RPC. Los setups de proveedor único fallan. Usa al menos dos — Alchemy e Infura, o uno gestionado y un nodo propio. Cambia en caso de fallo. El patrón de circuit breaker de Elixir aplica directamente aquí.
Picos de precio de gas durante cascadas de liquidación. Cuando múltiples posiciones se vuelven liquidables simultáneamente (una caída flash), el precio del gas puede subir 10–50x en segundos. Tu keeper necesita precios de gas dinámicos — ya sea ajuste de tip EIP-1559 o un gas oracle. Un keeper que envía con baseFee + 1 gwei durante un pico nunca se incluirá.
Acumulación de memoria en indexadores de larga ejecución. Los indexadores que procesan millones de eventos acumulan estado con el tiempo. Perfila el tamaño del heap después de 72 horas de operación continua, no solo durante el desarrollo. Los procesos GenServer en Elixir tienen su propio GC, lo que ayuda — pero la cola de escritura en Postgres todavía puede acumularse si tu indexador procesa más rápido de lo que puede escribir.
Eventos perdidos durante reconexiones de websocket RPC. Las conexiones websocket se cortan. Durante la ventana de reconexión, pierdes eventos. La solución: siempre mantén un cursor last_indexed_block y rellena los eventos perdidos al reconectar usando el método RPC eth_getLogs con un rango de bloques.
Checklist para Producción
Antes de salir en vivo:
- Dos proveedores RPC independientes con failover automático
- Detección de reorgs con profundidad de finalidad configurable (12 para mainnet, 3 para rollups optimistas)
- Estrategia de competencia del keeper — ¿estás protegido contra MEV, o aceptas la carrera?
- Integración con gas oracle con límites mínimos y máximos
- Backfill de eventos al reiniciar el indexador
- Alerta sobre heartbeats perdidos de procesos keeper
- Despliegue separado para indexador (lectura) y keeper (escritura) — tienen modos de fallo y características de escalado diferentes
El protocolo on-chain es la parte fácil. La infraestructura off-chain es donde los protocolos realmente viven o mueren.
Etiquetado en